
第 1 章
什么时候真的需要消息队列——三个问题定夺,一张任务表兜底
本章目标:
- 拿到一套选型判断:三个问题定夺要不要消息队列(MQ),每个问题都落到可观察的业务特征上
- 掌握任务表(Transactional Outbox)的完整实现:表结构、状态机、扫表协议、超时回收
- 看清装上 MQ 之后的三笔持续支出:堆积、重复、顺序——每一笔都对应一条可执行的防线
- 会判死信要不要人工介入,以及任务表到 MQ 的迁移时机
- 理解同一个选型在私有化交付和云上 SaaS 两种形态下为什么答案可以不同
本章基线:RocketMQ 4.9.x + MySQL 8.0 | 判断与表结构来自真实 B 端项目(日均投递十万级以内)| 最后核对 2026-11-01。日均投递远超百万级的系统不在这个范围——那一档的单表写入和消费模型都不一样
1.1 先看一个真实场景
订单服务创建完订单,要通知三个下游:库存预占、积分发放、短信提醒。云上的 SaaS 版第一版写法是订单事务提交后,串着调三个 HTTP 接口。积分服务一慢,订单创建跟着超时,用户在收银台前干等。
开发组把 RocketMQ 请了进来,问题解决。三个月后这套系统卖私有化,客户的内网只有 MySQL 和两台应用服务器,运维就一个人。RocketMQ 一套 NameServer 加 Broker 架构(NameServer 是注册中心,Broker 是存储转发节点,最少这两类进程)装是装上了,客户问了一句:这个坏了我们谁来修?
这个问题没有技术答案,只有成本答案。它值得在动手之前问,而不是装完之后被问。
1.2 三个问题:丢不起、等不起、通知几方
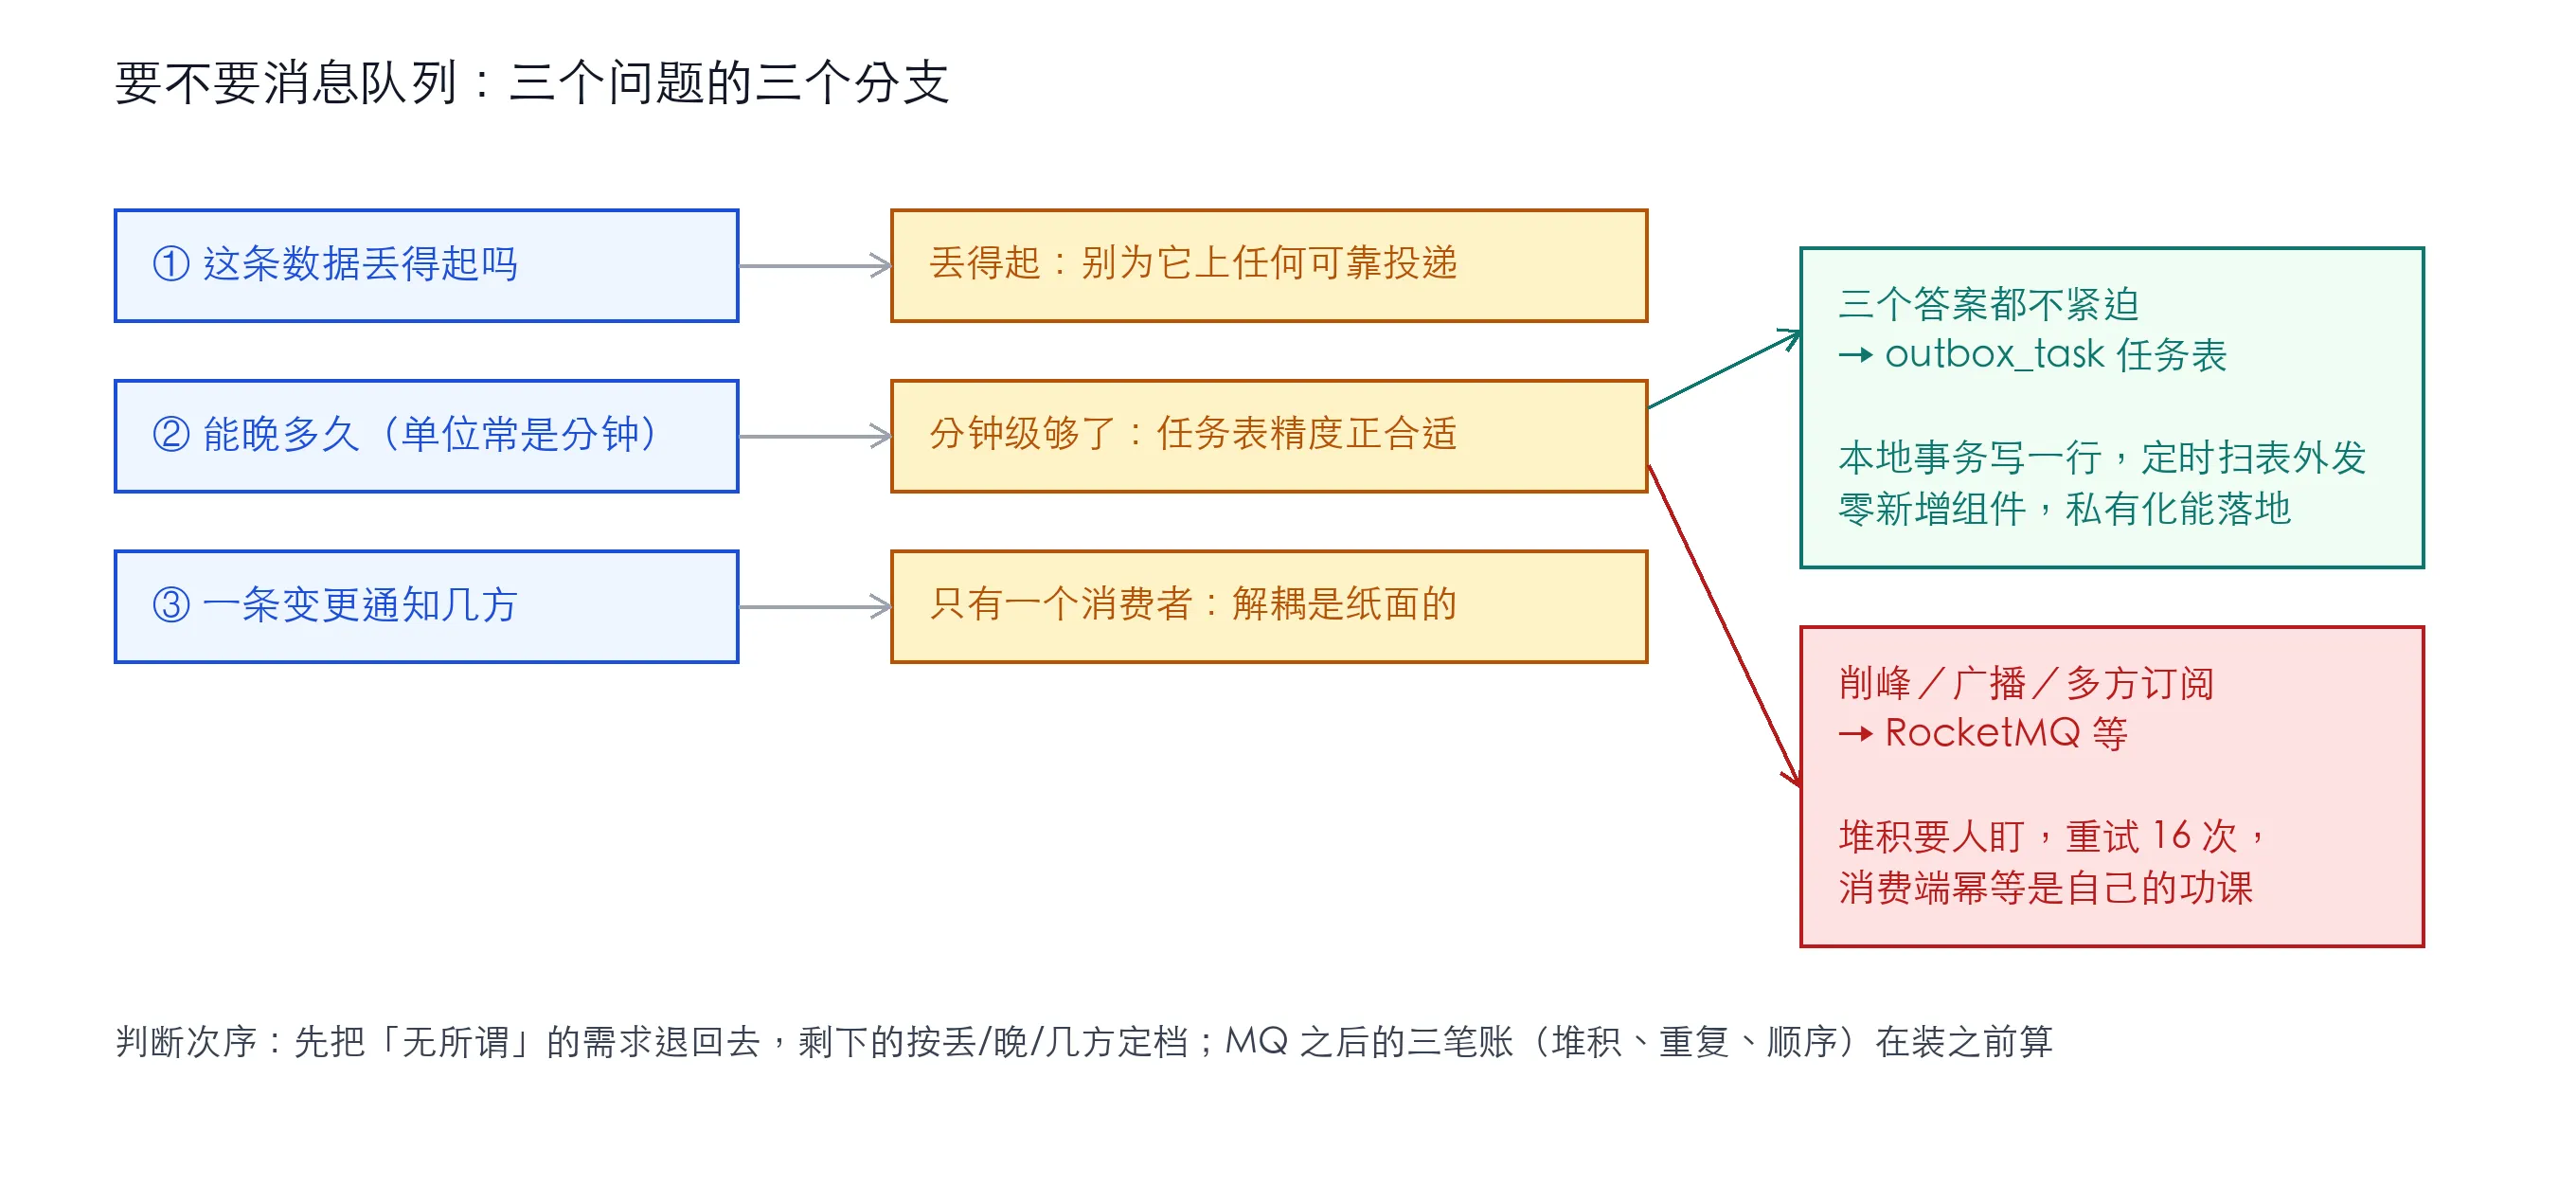
要不要 MQ,取决于三个问题的答案。每个问题都对应一种真实需求,一个一个过:
- 丢不起:订单要扣库存、支付要发积分,这类指令丢了就是资损或客诉;埋点上报、日志采集丢了就丢了,不值得为它们上可靠投递设施。很多人把第二类也搬进 MQ,等于花可靠的成本干不可靠的事。
- 等不起:判定标准落在业务上——异步之后这件事还成立吗。下单后十分钟发货可以异步,收银台等支付结果不能异步。注意「能晚多久」的单位经常是分钟不是毫秒,多数 B 端系统的异步需求按分钟计就够,这一条直接决定后面的选型。
- 通知几方:一个订单创建,库存要听、积分要听、风控也要听,日后还会冒出第四个第五个。这种「一条事件、多方订阅、消费者持续增加」的形状下,MQ 的解耦价值才真正兑现。如果从头到尾只有一个消费者,解耦是纸面上的:你不过把 HTTP 调用换成了 MQ 调用,多养了一套中间件。
把常见场景对着三个问题过一遍:
| 场景 | 丢 | 晚 | 几方 | 判定 |
|---|---|---|---|---|
| 支付成功发短信 | 丢得起(可重发) | 分钟级 | 1 方 | 任务表 |
| 订单创建通知库存预占 | 丢不起 | 秒到分钟级 | 1–2 方 | 任务表起步,量大迁 MQ |
| 秒杀流量削峰 | 丢不起 | 秒级 | 1 方,但瞬时量大 | MQ |
| 一条事件喂报表、风控、推荐多个团队 | 看情况 | 分钟级 | 3 方以上且在增长 | MQ |
| 埋点、日志收集 | 丢得起 | 小时级 | 1 方 | 哪个都别用,写文件或直接丢 |
削峰单独说一句:MQ 在这里的作用不是可靠投递而是蓄水池,瞬时写入先落队列,消费者按自己的节奏消化。这个场景没有低配替代——任务表扛不住秒级上万写入,单表写入吞吐先到顶。
1.3 三个答案都不紧迫:一张任务表
1.3.1 原理与建表
任务表的原理一行话:把「要发的消息」当成本地事务的一行数据写进数据库,提交事务的同时消息就落库了,另一个定时任务扫表往外发,发成功才改状态。这个模式叫事务发件箱(Transactional Outbox,本地事务和消息发送的原子性靠同一个数据库事务保证),它补的是 MQ 管不到的一段缝隙——业务事务已经提交、消息还没发出去,或者反过来。
CREATE TABLE outbox_task (
  id          BIGINT NOT NULL PRIMARY KEY,
  biz_type    VARCHAR(32) NOT NULL COMMENT 'order_created / stock_deduct',
  biz_id      BIGINT NOT NULL COMMENT '排障时回溯业务单据用',
  payload     TEXT NOT NULL COMMENT '消费者要的完整数据,JSON',
  status      VARCHAR(16) NOT NULL DEFAULT 'PENDING',
  owner       VARCHAR(64) NULL COMMENT '抢到这行的实例标识',
  next_retry  DATETIME NOT NULL COMMENT '不晚于它的行才会被扫到',
  retry_count INT NOT NULL DEFAULT 0,
  created_at  DATETIME NOT NULL,
  KEY idx_scan (status, next_retry)
);
payload 用 TEXT 别用 VARCHAR 定长——多行商品的订单 JSON 轻松超过 2000 字符,而 insert 发生在订单事务里,超长报错等于把下单一起拖垮。
1.3.2 扫表协议:抢占、退避、超时回收
状态机四态:PENDING → SENDING → SENT,重试耗尽进 DEAD。扫表每 5 秒一轮(经验值,按消费者承受力调),单批 200 行:
// 抢占:条件更新把行拨给自己,多实例天然错开
int claimed = jdbc.update(
    "UPDATE outbox_task SET status='SENDING', owner=? " +
    "WHERE status='PENDING' AND next_retry<=NOW() LIMIT 200", instanceId);
// 逐条发送;成功置 SENT
// 失败:retry_count+1,next_retry 按指数退避(第 n 次失败后 2^n 分钟再试),
//       超过 8 次标 DEAD 等人看
// 超时回收:owner 是自己但超过 10 分钟没动静的 SENDING 行,
//           重置回 PENDING——实例发送中途宕机时靠它兜底
SENDING 这个中间态是协议的核心:抢占和置 SENT 之间隔着一个网络调用,实例可能死在中间。没有超时回收,这些行会永远卡在 SENDING。
1.3.3 三个容易忽略的细节
- 完整数据:payload 存消费者要的完整数据,别存「事件类型让消费者回来查库」——查库又把两个系统在数据库层耦上了。
- 联合索引:扫描走「status 定前缀、next_retry 定范围」的路径,发完的行变成 SENT 后自然退出扫描范围,这才是 (status, next_retry) 联合索引真正的收益;单列 status 在表大了之后扫起来全是无效行。
- 死信出口:DEAD 状态的行要有人看的出口,接告警或管理页,否则它的名字叫死信但没人知道(介入判定见 1.5)。
1.3.4 至少一次投递:消费端幂等的功课
必须说实话的部分:任务表和 MQ 一样是至少一次投递(at-least-once,置 SENT 前宕机、超时回收、多实例抢占,任何一个环节都可能让同一条消息发两遍),消费者的防重一道都不少做。选任务表省下的是中间件的运维账,不是消费者幂等的功课。
1.3.5 容量账与三个天花板
任务表的真实容量比想象的大:消费者响应在几十毫秒级、单批 200 行的配置下,每秒几十条、每天百万级的投递量,一个扫表循环加两三个 worker 实例绰绰有余。它真正的天花板有三样——所有业务事务在同一张表上 insert 的写入热点(瓶颈在单表吞吐本身:redo 日志、自增主键页争用、连接数)、多实例抢行太细的扫描竞争、SENT 行不清理的表膨胀(每天百万级一年三亿多行,归档任务别忘了排)。三个天花板都碰到之前,私有化和中小 SaaS 的绝大多数异步需求到不了量。
1.4 决定上 MQ:先算三笔账
1.4.1 堆积:MQ 扛得住,业务扛不住
消费能力跟不上生产速度,消息在队列里排长队。MQ 自己扛得住亿级堆积,业务的时效性扛不住——积分晚发一小时没人发现,库存预占晚一小时就是超卖,因为这一个小时里货没有被占住,系统当它有货,接着卖就超了。堆积深度要进监控,但它量的是业务风险,不是中间件健康度。
1.4.2 重复:at-least-once 与防重键
MQ 的投递语义是至少一次,网络抖动就会把同一条消息投两次。重复不是意外,是常态。消费者的每个接口都得按业务键防重,防重键按业务事件选:支付回调用渠道流水号、退款用退款单号——同一个键重试必须不变,业务上允许重复发生的事件(比如部分发货)每次要有不同的键。防重键的完整设计在订单状态机那一章的 biz_key 一节展开。
1.4.3 顺序:并发消费与顺序消费的坑形状不同
同一张订单的「创建」「支付」「退款」三条消息被两个消费者并行处理,库存可能先收到退款再收到创建。RocketMQ 两种消费模式的坑完全不同:并发消费失败重试默认 16 次,重试消息转进重试主题按延迟等级重投、不堵同队列后面的消息,16 次耗尽进死信;顺序消费才是堵着后面等的那个,它的原地重试上限要显式配置,不配就一直在原地转。选哪个之前想清楚自己要哪种——要顺序就按业务键(订单号)选队列,跨键的顺序本来就不该互相等。
1.4.4 两行必须核对的配置
MQ 保证的是「发出之后不丢」,前提是 同步刷盘 + 同步复制 都配上:默认的异步刷盘在 Broker 宕机时会丢消息,私有化客户机器少的环境尤其要核对。这两行配置在「丢不起」的判定下是必选项,不是可选项。
1.5 死信要不要人工介入
判断落在钱上:丢掉的是货款、退款这类要紧事,就配人工出口和告警;埋点、提醒这类丢了能重造或能放弃的,自动过期就行。
| 死信里的东西 | 处置 | 理由 |
|---|---|---|
| 支付回调、退款指令 | 人工介入 + 告警 | 丢了是资损,重放要带业务核对 |
| 库存预占 | 人工介入 | 丢了超卖,但可按单核对补偿 |
| 积分、短信提醒 | 自动过期 + 计数 | 可重造,丢了影响可接受 |
| 埋点、日志采集 | 直接丢弃 | 本来就是尽力而为的数据 |
人工介入的出口要有三个件:能看的页面(死信列表带原文 payload)、能重放的动作(重放前允许改 payload)、能告警的规则(DEAD 行数 > 0 就报)。缺任何一个,死信就只是换了个地方丢。
1.6 迁移:任务表到 MQ 的触发信号
任务表起步不等于永远任务表。迁移的触发信号看两个数:outbox 写入占到业务库写 TPS 的一成以上,或者消费者涨到三家以上。碰到信号再迁,迁移分三步:
- 扫表任务的「发送」实现从 HTTP 调用换成 MQ 生产者,业务代码零改动——这就是 1.3 里「把投递实现写成通用组件」的回报。
- 消费者改从 MQ 收,防重逻辑原样保留(MQ 的 at-least-once 语义和任务表一样)。
- 双跑一段时间对账,outbox 发送量和 MQ 投递量对得上再停扫表。
反过来,别在只有一家消费者、每天几千条的时候上 MQ——那是用运维成本买纸面架构。
1.7 成本归属:同一个选型,两种交付形态
三笔账加起来,就是「客户问坏了谁来修」的完整答案:监控要看堆积深度,版本要跟着升,重试和死信要有人值班。这套运维成本,私有化客户全额承担,云上 SaaS 由平台团队摊薄。同一个技术选型,私有化和云上 SaaS 的答案可以不同,这不叫双标,叫成本归属不同——SaaS 里值得上 MQ 的那部分,到了一个运维就一个人的私有化环境,可能一张任务表才是负责任的选择。
1.8 本章小结
| 答案组合 | 选型 | 关键动作 |
|---|---|---|
| 三项全占(丢不起且晚不起且多方) | 直接上 MQ | 同步刷盘+同步复制;防重键按事件设计 |
| 只占一项 | 任务表起步 | outbox 写成通用组件,盯两个迁移信号 |
| 削峰或广播 | MQ | 任务表没有替代方案 |
| 三个都无所谓 | 同步调用+超时 | 把需求退回去再问一遍 |
MQ 是工具不是勋章。三个问题的答案比任何选型文章可靠;三个答案都不紧迫的系统,一张数据库任务表就能把事情做对,而且它在客户环境里是零新增组件。
1.9 练习题
- 给你现在的系统列一遍「事务提交后要通知的下游」,逐个过三个问题,标出哪些其实连任务表都不需要。
- 把 1.3.2 的扫表协议写成一个可跑的定时任务:两个实例同时扫,故意 kill 掉其中一个,观察超时回收把 SENDING 行救回来的过程。
- 给 outbox_task 造 10 万行 PENDING,EXPLAIN 看扫描走不走 idx_scan;再把其中 9 万行置 SENT,再看扫描行数的变化——体会「发完自然退出扫描范围」这句话。
- 把一个现有 HTTP 通知接口改造成消费端,设计它的防重键:哪次重复会撞键、哪次合法重放不能被挡?
1.10 延伸读
- 判定表和 outbox 协议的叙述版:什么时候真的需要消息队列
- 重复消费与顺序消费的完整对照:重复消费和顺序,哪个更难
- 死信处置的展开:死信队列要不要人工介入
- 消费端幂等最密的场景:支付回调出错时系统一声不吭
- 选型落地的部署形态:Docker 起一套本地环境