
第 2 章
多租户系统最容易出事的 8 个位置——它们都绕开了你写好的拦截器
本章目标:
- 建立「旁路」意识:隔离模型选对只是及格线,真正的事故都发生在绕过租户拦截器的路径上
- 逐处看懂八 个位置的症状、机制与修法——缓存、异步线程、定时任务、搜索索引、消息、文件、日志、数据源
- 掌握租户上下文的传递纪律:TaskDecorator 怎么写、finally 里哪两行不能少
- 会做验收:两个租户、三条订单、三件事、三个数
- 按自己的客户量级决定先补哪几处,不为整齐一次做完
本章基线:Spring Boot 3.x + MyBatis-Plus(租户插件)+ Spring Data Redis + Elasticsearch 7.17 | 八处全部来自真实生产事故与评审记录 | 最后核对 2026-11-01。一租户一库的独立部署模式不在这个范围;隔离模型怎么选是多租户不是加一个 tenant_id 那篇的事
2.1 隔离模型选对只是及格线
多租户系统里,大家花在「隔离模型选共享表还是独立库」上的时间最多,出事最多的却不是它。拦截器拼 tenant_id 这件事,多数系统只覆盖了「走 ORM 的普通查询」这一条路——另外八条路不经过它:缓存、异步线程、定时任务、搜索索引、消息、文件、日志、数据源。它们的共同点是都从你写好的那层防护旁边绕过去,而且绕得无声无息:代码评审看不出来,因为那段代码本身没错,错的是它没有上下文。
按炸的时间排。上线第一天炸的,和第一次月结炸的,不是同一个。
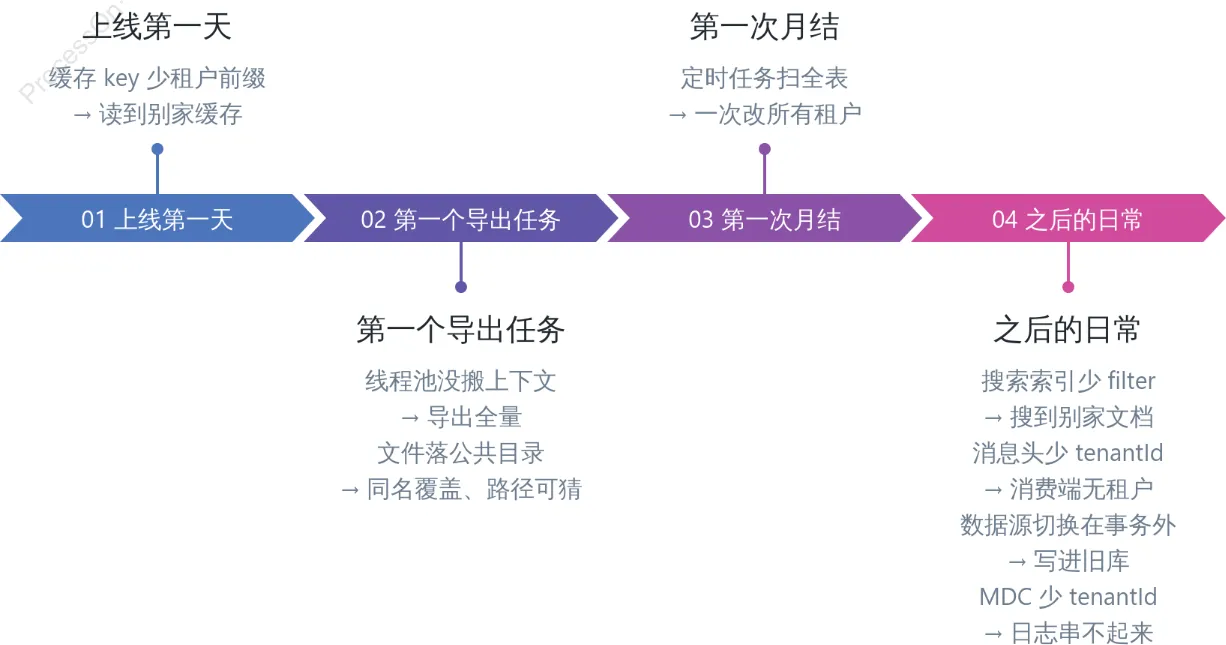
八处不必一次补齐:客户数没到量级,有几处可以先欠着,分寸见 2.7 的表。
2.2 上线第一天:缓存先把两家混在一起
缓存串号是这批事故里最吵的,通常当天就暴露:租户 A 的客户列表里出现租户 B 的客户,打电话过来的人当场就能说清现象。麻烦的是不吵的那一半——只缓存字典、行政区划的 key 也会串,但那些数据本来就该共享,没人发现;等某天有人往同一份缓存里塞了「按租户配置的业务参数」,它还是命中之前的共享 key,读出来是别的租户的值。这种串号的表现形式是「某个客户的开关莫名失效」,排查的人会先怀疑数据库。
@Cacheable 的 key 要带租户维度,而且只能在生成 key 的地方带:
// 对:全局兜底。这个 lambda 每次读写缓存都在当前线程求值一遍,
// Spring Data Redis 源码在这行上面的注释原话是 computing the key
// prefix on every call。它只覆盖 Redis 缓存,本地缓存不走它
RedisCacheConfiguration.defaultCacheConfig()
        .computePrefixWith(name -> "t" + TenantContext.require() + ":" + name + ":");
拿不到租户上下文就让请求死掉,比拼出一个 tnull: 前缀安全得多——拼出 tnull: 前缀的写法会把所有丢失上下文的调用合并到同一个缓存空间,而且它们看起来都命中正常。
有个容易写错的对照写法要钉死:随手注册一个 KeyGenerator bean 是当不了全局兜底的——Spring 取全局 KeyGenerator 的唯一入口是 CachingConfigurer#keyGenerator() 接口,bean 的名字它不认;就算配对了,显式写了 @Cacheable(key = "#id") 的方法也完全不经过 KeyGenerator,显式 key 的场合,租户要写进表达式本身。
同一类问题还有三个藏处:
- MyBatis 二级缓存:真正的雷是租户插件包在
CachingExecutor内层,cache key 按改写前的原始 SQL 算,两租户同语句同参数就命中同一个 key——租户拦截器必须包在 CachingExecutor 外层,或者对多租户实体干脆关掉<cache/>。 - 进程内的
ConcurrentHashMap当本地缓存:单机就能撞出跨租户,多实例更不用说。 ThreadLocal之外「顺手存一下」的静态字段:没有解法,只有禁令——grepstatic声明里带Map或Cache的行,命中即评审。
# 所有缓存注解整段过一遍眼睛,重点看 key 表达式里有没有租户。
# 别用 grep -v tenant 过滤:缓存名里带 tenant、key 里没租户的行会被整行放行
grep -rn -A2 -E "@Cache(able|Put|Evict|Config)" src/main/java
grep -rn -A3 "<cache" src/main/resources
前两个藏处的解法一句话:租户并进 key 的算法里,别并进 value 的判断逻辑——key 决定你能不能命中,命中之后要不要再过滤一遍是权限的事。
2.3 第一个导出任务:上下文在线程池里丢了
异步这条是作者真实踩过的:接口把任务丢进线程池就返回了,工作线程里没有租户上下文,查询走到「没有租户条件」的分支,导出的是全量订单文件,文件再传到公共目录。排查花了一下午,因为看代码的人一直以为上下文是全链路都在的。
机制一句话:租户上下文放在 ThreadLocal,而线程池的线程不是你的请求线程。反复让人栽的是三个细节:
- 继承失效:
InheritableThreadLocal只在创建线程的那一刻复制父线程的值,而ThreadPoolExecutor默认到提交第一个任务才建线程——继承到的是触发建线程那一次提交的租户,之后所有任务共用它。你看到的现象是「这个线程永远认为是租户 A」。 - 绕过装饰器:
CompletableFuture.supplyAsync不传 executor 就走ForkJoinPool.commonPool,你给业务线程池装的所有装饰器一概不生效;@Async不指定 executor 用默认那个;第三方 SDK 内部的回调线程池根本不接受你的包装。 - 结束不清:任务结束必须
clear()。少这一行,池里的线程带着上一个任务的租户跑下一个任务,故障从「查不到数据」变成「查到了别人的数据」,这一种贵得多——偶发、难复现,报上来的人还会说「我什么都没做」。
标准写法是给线程池配 TaskDecorator,提交时捕获、运行时恢复、结束时清理:
public class TenantAwareTaskDecorator implements TaskDecorator {
    @Override
    public Runnable decorate(Runnable runnable) {
        Long tenantId = TenantContext.getOrNull();   // 提交任务那个线程的上下文
        return () -> {
            if (tenantId != null) {
                TenantContext.set(tenantId);
                MDC.put("tenantId", String.valueOf(tenantId));
            }
            try {
                runnable.run();
            } finally {
                MDC.remove("tenantId");
                TenantContext.clear();               // 两行都得有
            }
        };
    }
}
取上下文用 getOrNull(),空就原样留空——这里不能调 require():有些全局任务本来就没有租户,装饰器的职责是把提交线程的上下文原样搬过去,不是替工作线程做校验;工作线程里的查询拿不到租户会自己失败,那个堆栈离问题更近。
三种传递写法的适用范围不重叠,按线程池是谁建的挑:
| 写法 | 够用 | 不够用 |
|---|---|---|
InheritableThreadLocal |
一次性脚本、手动 new Thread |
任何线程池:值在创建时就定死了 |
TaskDecorator |
自己造的池、@Async 指定了 executor |
CompletableFuture 不传 executor 时绕过它 |
TransmittableThreadLocal |
要同时透传租户、操作人、traceId | 得挂 agent 或手动 capture,栈更难读 |
2.4 第一次月结:定时任务把三十家算成一家
定时任务的上下文天然是空的:没有 HTTP 请求,没有登录用户,拦截器拼不上条件。于是按租户汇总的语句扫成全表,或者更常见——扫全表之后连租户都不分组,直接把所有客户的数字加在一起。发现时间取决于你的月结是几号;这一条炸在钱上,报上来的是财务或代理商。
调度入口要显式列租户,循环内 set、finally 里 clear,一家失败不影响其余:
@Scheduled(cron = "0 30 2 * * ?")
public void settle() {
    for (long tid : tenantService.activeIds()) {        // 靠租户表驱动,不靠全表扫
        try {
            TenantContext.set(tid);
            settlementService.settlePeriod(tid, tenantService.billingPeriodOf(tid));
        } catch (Exception e) {
            log.error("settle failed, tenant={}", tid, e);   // 记下跑到哪一家
        } finally {
            TenantContext.clear();
        }
    }
}
结果表按租户加账期做幂等,主键配合写入端 upsert,重跑才是覆盖而不是报错:
CREATE TABLE biz_settlement (
  tenant_id   BIGINT      NOT NULL,
  period      CHAR(7)     NOT NULL,   -- 2026-11
  amount      DECIMAL(14,2) NOT NULL,
  settled_at  DATETIME    NOT NULL,
  PRIMARY KEY (tenant_id, period)     -- 配合 INSERT ... ON DUPLICATE KEY UPDATE
);两个只在多租户下出现的问题:账期不一致——有的客户月初结、有的月底结、有的按自然周,cron 只有一个触发时刻,账期得从租户参数里读(上面 billingPeriodOf(tid) 干的事),别写死「上个月」;多实例撞车——两个实例同时到点,同一家的月结跑两遍。分布式锁的粒度要落到租户(lock:settle:{tenantId}:{period}),全局一把锁会让三十家排队等一个跑失败的。作者的做法是让账期主键兜底,锁只加在「同一个租户不能并发」这一层。
私有化部署后还有一层:客户自己的服务器时区可能和 SaaS 那边差八小时,写死的日期函数在两台机器上算出来的不是同一个月份——容器时区的坑在本地环境那一章的 1.6.4 有实拍。
2.5 之后的日常:索引、消息、文件、日志、数据源
剩下五处没有前三个准时炸,每一处都在等对应的业务第一次出现。
搜索索引
ES 的文档里必须有 tenant_id 字段,查询强制包最外层 term filter。routing=tenantId 让一次查询只打一个分片,前提是写入端也用同一个 routing——只改查询端,文档散在所有分片上,本租户的文档被静默查丢,比查得慢难发现得多。
long tenantId = TenantContext.require();
BoolQueryBuilder q = QueryBuilders.boolQuery()
        .filter(QueryBuilders.termQuery("tenant_id", tenantId)); // 包在最外层
SearchRequest req = new SearchRequest("idx_order").routing(String.valueOf(tenantId));
req.source().query(q);
这段代码的问题不在写法,在于能不能被绕开:列表页、全局搜索框、报表导出、内部 RPC,只要有一个入口「前端传什么索引名就查什么」,过滤就没了。约束要落在「谁能拼索引名」上——查询入口收进一个只接受 SearchIntent 的方法,索引名由服务端算。用通配符或 _all 的索引名等于绕过所有租户条件。
消息
租户放消息头(或消息体)里,消费端从头里取——不要拿业务 id 回数据库反查租户,反查正好又需要上下文,等于把问题挪到下一个环节。重试和死信重放是同一坑的第二层:重投时原始上下文早就没了,租户要么在消息里,要么在业务数据本身能推导出来的地方。顺序消息还有个附加要求:按租户选队列(Kafka 用 key = tenantId),跨租户的顺序本来就不该互相等。
文件
路径前缀按租户分段(export/{tenantId}/{yyyyMMdd}/{jobId}.xlsx),本地临时目录按任务分而不是按进程分,预签名 URL 给短有效期。下载链接那一侧还要再过一次权限:文件名里带租户不等于只有这家能下,签名 URL 过期之前谁都行,链接生成时要校验请求人属于这个租户。客户要源码买断或私有化时,前缀必须做成可配置项——目录结构在别人的机器上,硬编码的桶名会在交付当天改一遍。
日志
就一件事:MDC 里放 tenantId 并打进 pattern。放进 pattern 的值不会自己出现——线程池装饰器和定时任务循环里,TenantContext.set 的后面都跟着一行 MDC.put,finally 里先 MDC.remove 再 clear(2.3 的代码已经是这个形状)。MDC 是线程本地的,漏了这对动作,池化线程要么带着上一个任务的租户写日志,要么 t= 整段是空。跨租户的问题九成是「某个客户独有」,没有这个字段就只能靠时间点猜是谁。
<encoder>
  <pattern>%d{HH:mm:ss.SSS} [%thread] t=%X{tenantId} %-5level %logger{36} - %msg%n</pattern>
</encoder>
数据源
共享表和独立库混用(大客户独立库、小客户共享表)之后,切换必须发生在拿到连接之前:AbstractRoutingDataSource 在 getConnection() 的那一刻决定路由,而事务一开启连接就绑定了,@Transactional 方法内部再改上下文无效。这类 bug 长得像缓存问题——数字是对的,只是属于隔壁租户。切库放在最外层,租户解析完立刻确定数据源,整个请求生命周期不再改。
2.6 验收:不靠读代码,靠造数据
两个租户各灌三条订单,然后跑三件事:一次缓存预热、一个导出任务、一次月结。跑完只看三个数:
- 返回的行数:租户 A 的导出必须是 3,出现 6 就是漏条件。
- 日志里 t= 有没有值:异步任务尤其要看,线程名和租户的对应关系能告诉你装饰器有没有生效。
- 落盘路径和缓存 key 前缀:
redis-cli --scan看实际生成的 key,比看代码诚实。
这条验收可以挂进 CI——它看的全是可观察的输出:
@Test
void exportJobKeepsTenant() {
    long a = seedTenant("A", 3), b = seedTenant("B", 3);
    ListAppender<ILoggingEvent> logs = attachCollectorToRootLogger();
    runExportJob(a);
    assertThat(orderIdsIn(lastExportFile())).allMatch(id -> belongsTo(a, id));
    // MDC 是线程本地的,断言落在任务执行期间采集的日志行上,
    // 直接断言测试线程自己的 MDC 永远是空——那是在错误的线程上找值
    assertThat(logs.list).anyMatch(
        e -> String.valueOf(a).equals(e.getMDCPropertyMap().get("tenantId")));
}
再加一道静态检查更省事:把 2.2 的 grep 放进流水线,命中数超过上次就失败——缓存声明总数在一个项目里是缓慢增长的,用它当基线比当待办清单靠谱。先修命中数最多的那一类,别按文章的序号修。
2.7 按客户量级决定补哪几处
八处不必一次补齐,按你现在的规模挑,剩下的记进待办:
| 现在的情况 | 必须先补 | 可以先欠 |
|---|---|---|
| 三家以内,同一个库,没有异步任务 | 缓存 key、日志 MDC | 索引 routing、数据源切换 |
| 十几家,有导出或报表 | 上面两处 + 线程池上下文传递 | 消息头(还没上 MQ 就无所谓) |
| 开始按租户月结 | 定时任务的租户循环 + 幂等键 | 一租户一索引 |
| 客户要求私有化或源码买断 | 文件前缀可配置、缓存能按租户清干净 | 多租户查询路由优化 |
| 出现外部代理商结算 | 幂等键和归属快照 | 没有 |
反过来看更省事:只要系统里还没有异步任务、还没有导出、还没有月结,后几处的风险就都是潜在的。表从下往上读,停在你现在能负责的那一行。
2.8 八处自查清单
- 缓存 key 带租户:全局前缀用
computePrefixWith生成,别指望 KeyGenerator - MyBatis 二级缓存:租户插件包在 CachingExecutor 外层,或对多租户实体关掉
<cache/> - 异步任务:TaskDecorator 提交时捕获,finally 里 remove 和 clear 两行都得有
- 定时任务:入口显式列租户循环,结果表主键带 (tenant_id, period) 配 upsert
- 搜索索引:文档带 tenant_id,查询包最外层 filter,写入和查询用同一个 routing
- 消息:头里带 tenant_id,消费端取头,不拿业务 id 反查租户
- 文件:路径按租户分段,签名 URL 生成时校验请求人归属
- 日志:MDC 放 tenantId 进 pattern,set 后跟 put,finally 先 remove 再 clear
- 数据源:切库发生在拿到连接之前,整个请求生命周期不再改
2.9 本章小结
八处的一个共同点值得再念一遍:它们都不在「写 SQL」的那条路上,所以拦截器帮不上忙;它们的修法也高度一致——让租户跟着数据走(key、消息头、路径、文档字段),而不是指望执行现场能猜出租户。上下文传递的三条铁律:提交时捕获、运行时恢复、结束时清理,异步和定时任务一个都不能少。
2.10 练习题
- 在你的工程里跑 2.2 的两条 grep,数一遍命中:缓存注解里 key 表达式带租户的有几处?这就是你现在的真实水位。
- 写一个测试复现 2.3 的「继承失效」:用
InheritableThreadLocal+ 线程池,第一个任务提交租户 A、第二个提交租户 B,打印两个任务各自看到的租户。 - 给月结任务造一次并发:同一租户两个线程同时跑,验证 (tenant_id, period) 主键 + upsert 下结果表只有一个版本的数字。
- 把 2.6 的验收测试抄进你的项目跑一遍——第一次跑不过的位置,就是你现在欠账最多的那一处。
2.11 延伸读
- 隔离模型怎么选(共享表、独立库、混合):多租户不是加一个 tenant_id
- 八处之外,列表页越权那一层:权限系统:RBAC 不够用的地方,数据权限怎么补
- 每处的完整叙述与更多代码:多租户系统最容易出事的 8 个位置
- 日志 MDC 的另一半(traceId 贯穿):日志排查三板斧