
第 1 章
日志排查三板斧——先分口径、traceId 贯穿、结构化与分级
本章目标:
- 学会把「系统很卡」拆成可动手的口径:全部慢、单租户慢、单接口慢、间歇性慢,各查各的地方
- 掌握 traceId 的完整贯穿:Filter 生成、线程池装饰器、MQ 消息头、定时任务、响应头透出
- 会设计能回答「这一次请求发生了什么」的日志:字段清单、采样、保留期、脱敏收口
- 知道小团队先建哪四组指标、配哪几条告警——以及为什么先别买 APM
- 拿走一组定界用的 SQL 和 JVM 命令,出事时按图索骥
本章基线:Spring Boot 3.x + Logback + Micrometer/Prometheus + RabbitMQ | 适用于日均千万级请求、峰值几百 QPS、个位数实例的小团队规模 | 日志样例取自生产 nginx 与应用容器(2026-11-01 实拍),真实 IP、版本号与内部类名已脱敏。日志管道的成本核算不在这个范围
5.1 凌晨一点半,「系统很卡」
客服在群里发了一句「系统很卡」。这句话里没有一个能直接动手的信息:是全部客户都慢还是只有一家;是所有页面都慢还是只有导出;是十分钟前开始,还是从晚上八点就断断续续。值班的人如果先打开监控大盘,看到一片绿色,往往会回一句「我这边看正常」,然后两边开始互相怀疑。
先问三句话:哪几个客户在反馈,具体点的哪个页面,第一次出现大概是几点。客户说都卡,但名单里只有三家而且都在同一个区域——先查网络和那台应用实例(哪一台,用访问日志里的来源 IP 反查);三家分布在不同区域、卡的是同一个功能——方向变成这个功能的公共依赖。问完这三句,方向通常只剩「网络或单实例」和「某个公共依赖」中的一个。
5.2 第一板斧:先把「卡」拆成口径
四种慢,方向完全不同,查错方向的动作也是错的:
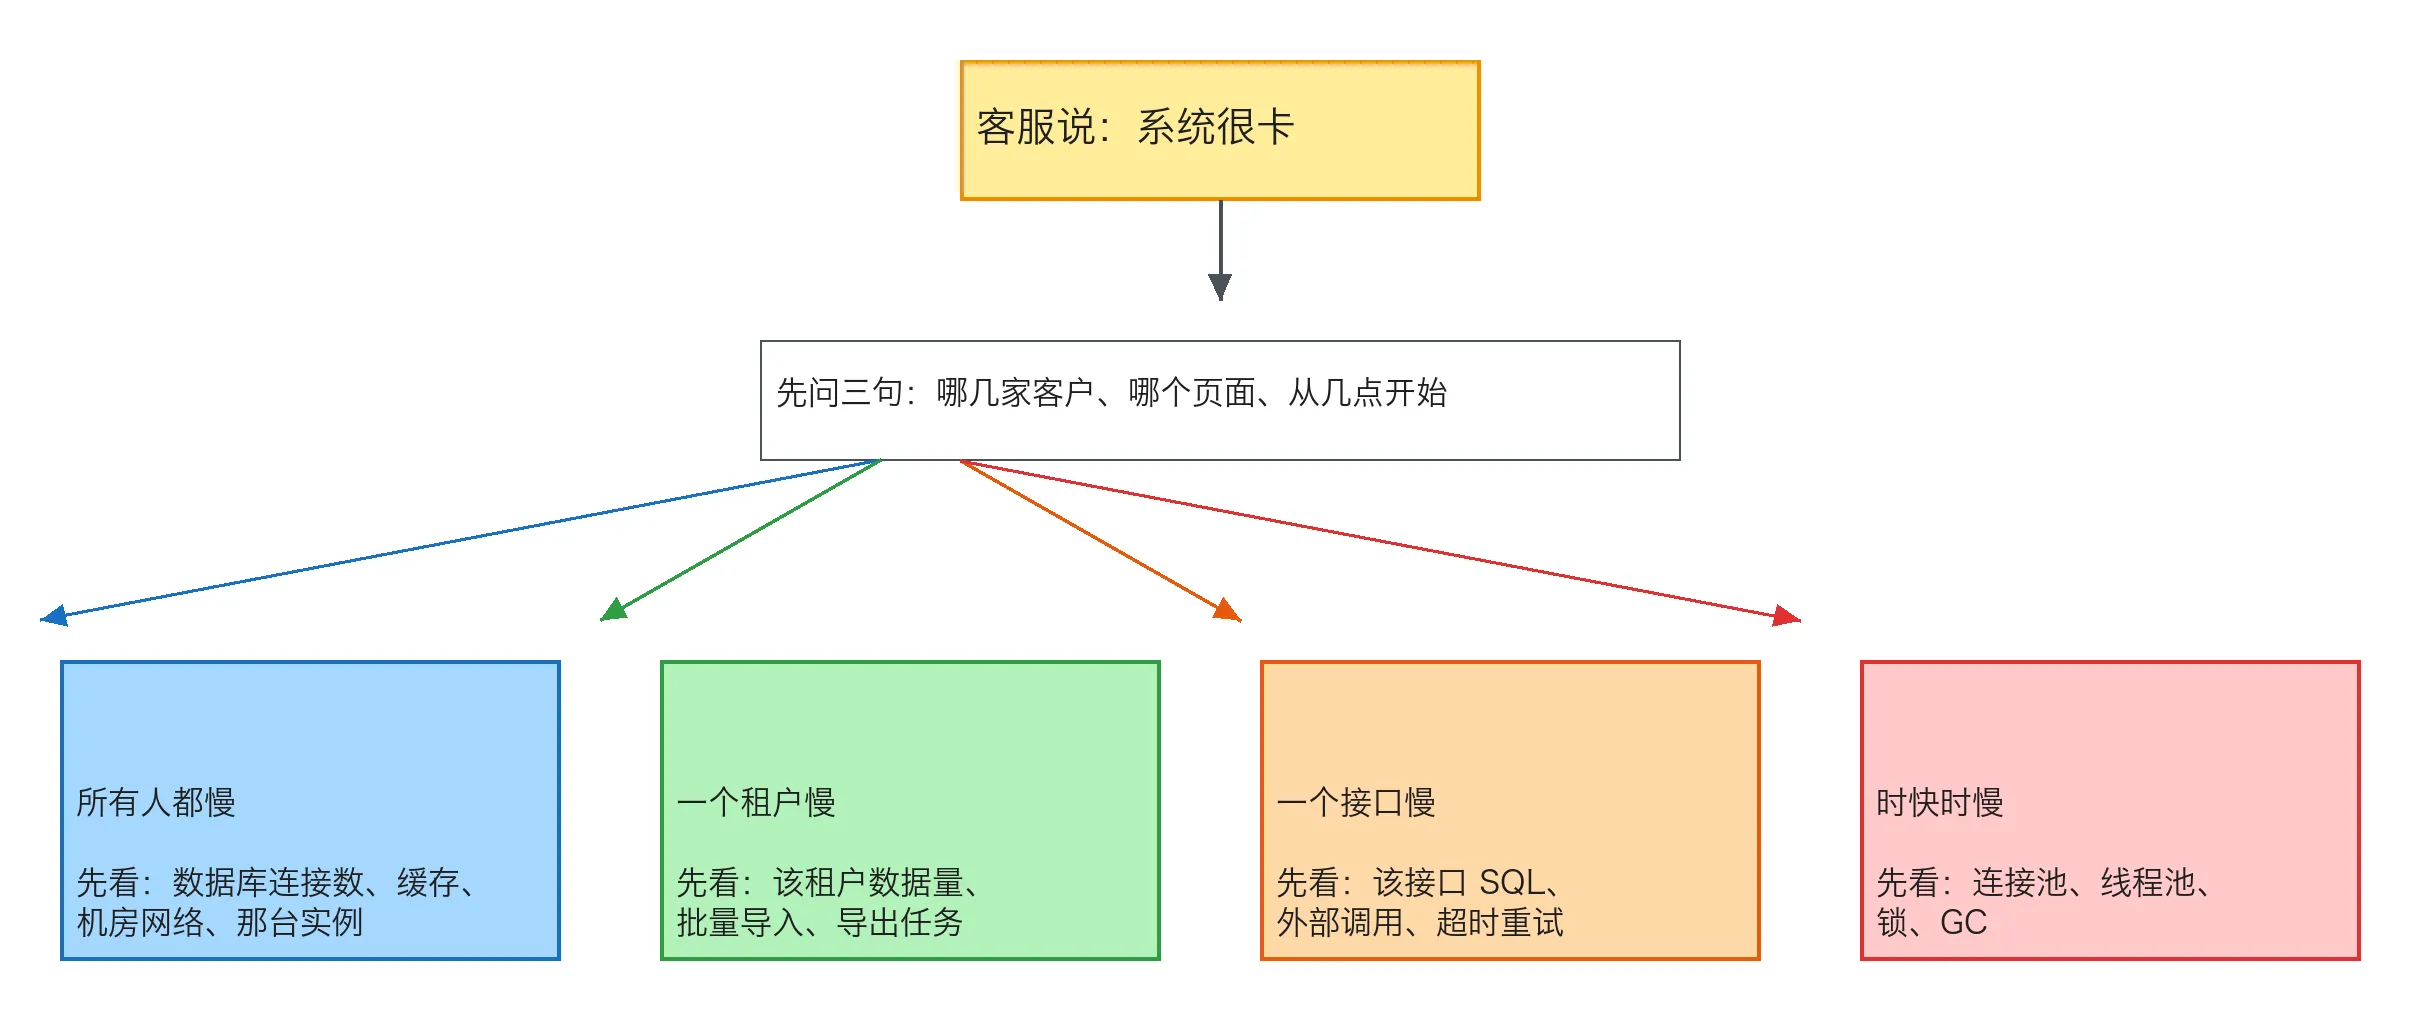
| 口径 | 先看什么 | 为什么 |
|---|---|---|
| 全部人都慢 | 共用资源:数据库、缓存、网络、某台机器 | 问题在公共路径上 |
| 一个租户慢 | 这个租户的数据量、最近批量导入、导出任务 | 大概率是它自己的数据行为 |
| 一个接口慢 | 这个接口自己的 SQL 和外部调用 | 局部问题局部查 |
| 时快时慢 | 连接池、线程池、锁、GC | 资源在临界点抖动 |
方向错配的代价很具体:把「所有人都慢」当成「某个接口慢」去查,会在应用日志里翻两个小时,最后发现是数据库连接数打满;把单租户的数据问题当成全局故障,会去重启整套服务,把本来只是慢的请求变成失败。
还有一个前置判断别漏:先分客户端和服务端。前端说慢,打开浏览器的时间线看是请求排队、接口返回慢,还是页面渲染卡;服务端日志显示 200 毫秒、用户还是觉得慢,问题可能在一个页面发了几十个请求,或者一张表渲染了五千行。这个判断不做,应用日志里什么也看不出来。
5.3 第二板斧:traceId 是成本最低的一条线
一个请求进来,生成一个 id,放进日志的每一行,返回给调用方,再传给下游。客户报问题时报的是订单号,你从订单号找到那次请求的 traceId,就能把这一单经过的所有日志串起来,不用再靠时间戳猜。如果今年只能补一样东西,选它。
@Component
@Order(Ordered.HIGHEST_PRECEDENCE)   // 必须压过 Spring Security 默认的 -100,不然拿不到最外层
public class TraceFilter extends OncePerRequestFilter {
    // 大写 hex 和带横线的 UUID 原样放行,把上游生成的 id 换掉,跨系统就串不起来了
    private static final Pattern OK = Pattern.compile("(?i)[0-9a-f-]{16,36}");

    @Override
    protected void doFilterInternal(HttpServletRequest req, HttpServletResponse res,
                                    FilterChain chain) throws ServletException, IOException {
        String inbound = req.getHeader("X-Trace-Id");
        String traceId = (inbound != null && OK.matcher(inbound).matches())
                ? inbound : UUID.randomUUID().toString().replace("-", "").substring(0, 16);
        MDC.put("traceId", traceId);
        res.setHeader("X-Trace-Id", traceId);
        try {
            chain.doFilter(req, res);
        } finally {
            MDC.clear();
        }
    }
}
三个细节别省:外部传进来的 X-Trace-Id 不能直接信,长度和字符先校验,不合规就重新生成;响应头里的 traceId 要在错误页和前端拦截器里显示出来,报错弹窗带一行「故障编号」,客户才有的发;Boot 3 的包是 jakarta.servlet.*,Boot 2 是 javax.servlet.*,import 抄错编译不过。
MDC 是 ThreadLocal,任务丢进线程池之后上下文就没了——日志里会出现一堆没有 traceId 的行,事后基本查不动。这在多租户那一章讲租户上下文丢失时是同一个机制,这里丢的是同一个东西的另一半:
public class MdcTaskDecorator implements TaskDecorator {
    @Override
    public Runnable decorate(Runnable task) {
        Map<String, String> ctx = MDC.getCopyOfContextMap();
        return () -> {
            if (ctx != null) MDC.setContextMap(ctx);
            try {
                task.run();
            } finally {
                MDC.clear();
            }
        };
    }
}
声明成 Bean 只对 @Async 的默认线程池生效;自建的 ThreadPoolTaskExecutor 要手动 setTaskDecorator,@Scheduled 的调度线程池也要单独包一层。发 MQ 时把 traceId 写进消息头(生产端 setHeader("traceId", MDC.get(...)),消费端第一行取出来放进 MDC,finally 里 clear);定时任务每次执行生成一个新的,日志里至少能分清是哪一个批次。这些都是一次性工作,做完之后每一次排查都省时间。
5.4 第三板斧:日志要能回答「这一次请求发生了什么」
有了 traceId,日志还得有内容可看。最少要有这些字段:时间、级别、traceId、租户、用户、来源 IP、实例标识、方法、路径、状态码、耗时、错误码——来源 IP 和实例标识是「哪几家客户打到哪台机器」的证据,少了它们,同区域慢就定位不到那台实例。
两个真实日志行,拆给你看这套口径长什么样。第一行来自生产 nginx 的访问日志(combined 格式,服务端接入层的证据):
115.60.x.x - - [01/Nov/2026:22:01:06 +0800] "GET /knowledge HTTP/2.0" 200 23994
    "-" "curl/8.7.1"
└来源 IP        └时间 + 时区          └方法 路径  协议      └状态 字节 └UA(curl 探测)
(真实日志每条一行,此处为排版折行,字段原样。)
第二行还是这台服务器的 access.log——爬虫长什么样一眼可辨,识别和屏蔽都靠 UA 这一列:
216.73.x.x - - [01/Nov/2026:22:01:20 +0800] "GET /apple-touch-icon.png HTTP/2.0"
    200 7650 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko;
    compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"
第三行是应用容器里的定时任务日志(Logback 默认风格),注意线程名 scheduling-6670——没有 traceId 的定时任务日志,能靠线程名和批次号分清轮次:
2026-11-01T03:00:00.001+08:00  INFO 1 --- [scheduling-6670] p.a.m.t.RememberTokenCleaner
    : Expired remember me tokens have been cleaned up.
└ISO 时间 + 时区          └级别  └容器进程号  └线程名
└缩写 logger                    └消息
(三段日志都取自生产实拍,但不是原样照贴:IP 打了码、logger 缩写做了改写、版本号抹掉。发出来的日志和 5.4 要讲的日志纪律是同一件事——教学要的是格式骨架,不是哪台机器在跑什么。)
应用日志的 pattern 把 traceId 和租户放进中括号,这一行才有用:
<pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} %-5level [%X{traceId}] [%X{tenantId}]
  %logger{36} - %msg%n</pattern>
pattern 里出现的 %X{tenantId} 要有人放:租户解析的 Filter 里 MDC.put,finally 里 remove;方法、路径、状态码、耗时走访问日志过滤器在收尾处补进 MDC,不然 pattern 打出空括号。业务的关键动作再补一条(下单、支付回调、退款受理),让日志能当事件流看。
三条纪律,每条背后都是一次真实事故形态:
- 别打请求体和响应体:里面有手机号、身份证、地址、支付报文,出了问题日志本身就是事故。要排查就打字段级摘要,敏感值脱敏,脱敏收口到统一的日志工具方法里——所有 log 调用走同一个包装,不要散在各业务代码里自己 replace,一旦落盘就已经晚了。
- 异常打完整堆栈:只打
e.getMessage()的时候,线上那行日志通常等于「空指针」,什么也说明不了。 - 级别要克制:参数校验失败是业务结果,打 WARN 就够;每一条 ERROR 都应该意味着有人需要来看一眼。生产 DEBUG 忘关、磁盘两天写满,这种事比代码 bug 更常见——应用侧和容器侧都要设上限,别只设一处。
采样与保留期
访问日志按量采样,错误和慢请求全留。平均一两百 QPS 的系统,一天访问日志就是上千万行,访问加应用日志合计按一天 8G 的速度,二十天就把 200G 的盘吃满;按 10% 采样,再加「耗时超过 1 秒的全留」,比例不大,关键的一次也不会漏——keep = status >= 500 || costMs > 1000 || counter.incrementAndGet() % 10 == 0。保留期按磁盘倒推,不要按「合规要求」随口定一年:落点在 logback SizeAndTimeBasedRollingPolicy 的 maxFileSize、maxHistory、totalSizeCap 三个参数上,totalSizeCap 要给数据库目录留出余量;真要留一年,进对象存储,查的时候再拉回来。
5.5 指标先建四组,不要先买 APM
小团队最容易走的两条弯路:买一套重型 APM,装完没人看;只盯 CPU 和内存,CPU 一高就扩容,扩完还是慢。按四组建:接口组(p95 加错误率)、池组(数据库连接池等待数加业务线程池队列长度)、磁盘使用率、GC 停顿。前三样第一天就要,GC 可以晚一周。
management:
  endpoints:
    web:
      exposure:
        include: health,metrics,prometheus
  metrics:
    tags:
      application: ${spring.application.name}
      instance: ${HOSTNAME:unknown}
    distribution:
      percentiles-histogram:
        http.server.requests: true
两个依赖细节:prometheus 端点要先引入 micrometer-registry-prometheus,没有它这个端点不存在;不开 percentiles-histogram 就没有 bucket,Prometheus 的 histogram_quantile 写不出来,p95 告警无从谈起。对指标名:错误率用 http_server_requests_seconds_count 的 status 标签,连接池等待是 hikaricp_connections_pending,GC 停顿是 jvm_gc_pause_seconds,磁盘是 disk_free_bytes。
两条反直觉的经验:CPU 高不等于系统慢——批量任务把 CPU 打到 90% 而接口还是 200 毫秒,叫资源用满了没影响业务;CPU 只有 20% 但连接池等待一直大于零,请求全卡在拿连接上。看 CPU 决定扩容,经常是拿一个不相关的数做了一个昂贵的决定。平均耗时更会骗人:一百个请求里九十九个 100 毫秒、一个卡十秒,平均不到 200 毫秒;这种单点长尾 p95 未必看得见,只有最大值抓得住——慢请求要单独留痕。指标至少能按实例、按版本拆开,发布后新旧并存的那几分钟,没有版本标签根本分不清是谁慢。接口指标别拿 userId、orderId 当标签,基数会炸;租户标签先按「租户数 × 接口数 × 状态码数」估总量,吃不消再抽样。
5.6 告警要少,每条都得能动手
告警只报用户能感知的症状:五分钟错误率超过 1%、p95 连续十分钟超过一秒、回调队列积压超过一千条、磁盘超过 85%。CPU、内存这类资源指标只在容量规划时看;磁盘是例外,写满就是事故,所以它进告警表。告警一多,等于没有告警。
| 告警 | 先看什么 | 常见原因 | 止血动作 |
|---|---|---|---|
| 五分钟错误率 >1% | 按接口拆错误码,找第一个报错的时间点 | 新版本、外部依赖、数据库 | 回滚上一版或摘掉异常实例 |
| p95 连续十分钟 >1s | 慢接口排序,再看它的 SQL 和外部调用 | 索引失效、连接池、下游超时 | 限流、扩容、临时关非核心功能 |
| 回调队列积压 | 消费者是否存活,单条处理耗时 | 消费线程卡住、下游慢、流量突增 | 加消费者,先把毒消息隔离 |
| 磁盘 >85% | 日志目录、上传目录、数据库目录 | 日志没切、临时文件、备份堆积 | 清日志、挪备份、扩盘 |
| 连接等待 >0 持续五分钟 | 活跃连接数、慢查询、锁等待 | 连接泄漏、慢 SQL、长事务 | 杀长事务,回滚有问题的发布 |
这张表是给值班的人半夜照着做的,三条使用纪律:「限流」「临时关功能」有前提——入口有限流配置、功能有开关,没有开关的功能别写进 Runbook,写了也拔不动;每条告警后面记一行「上次发生是什么时候、当时怎么处理的」,比任何监控工具都值钱;同一条规则误报三次以上就改阈值或删掉——误报必须有反馈回路,不改,下一次真出事就没人接了。告警还要有主人,没有主人的告警三个月后没人敢删。
5.7 定界要靠几条命令和 SQL
应用日志说「慢」,下一步确认慢在哪。数据库先看正在跑的语句和锁,不要一上来就重启:
-- 现在谁在跑,凌晨定位从这张表开始
SELECT id, user, db, time, state, LEFT(info, 100) AS sql_head
FROM information_schema.processlist
WHERE command <> 'Sleep' ORDER BY time DESC;

-- 超过 60 秒的事务,「杀长事务」先用它定位,再 KILL 线程号
SELECT trx_mysql_thread_id, trx_started, trx_rows_locked
FROM information_schema.innodb_trx
WHERE trx_started < NOW() - INTERVAL 60 SECOND;

-- 当前连接在等什么,谁挡住了它
SELECT waiting_pid, blocking_pid, waiting_query, blocking_query
FROM sys.innodb_lock_waits;
sys.innodb_lock_waits 里 blocking_query 有时显 NULL——占锁方躺在一个空闲事务里,这时拿 blocking_pid 去 processlist 对。JVM 这边:jcmd <pid> Thread.print 连续打三次间隔五秒,卡在同一位置的线程就是嫌疑;jcmd <pid> GC.heap_info 看老年代(JDK 8 用 jstat -gcutil <pid> 1000);堆 dump 文件很大,别在磁盘快满的时候打。
外部调用要看超时和重试配置:一个下游超时三秒、失败后再重试两次(连首次共三次尝试),一个请求最坏九秒;配置写成「失败后再试三次」就是十二秒——日志里看到的是「很慢」,根因在配置里。把每个外部依赖的超时、重试、熔断值列成一张表,出问题时先对一遍,比翻代码快。
5.8 本章小结
顺序别反过来:先 traceId 打通,再补日志字段,然后建四组指标,接着配少量告警和 Runbook,最后才是大盘。大盘是给人探索用的,不是告警的入口;先有大盘再补 traceId,最后会得到一面很好看但回答不了「这一单为什么慢」的墙。
| 时间预算 | 做什么 |
|---|---|
| 只有半天 | TraceFilter + 日志 pattern 加 %X{traceId},响应头透出 |
| 两天 | 上面 + MdcTaskDecorator/MQ 头传递 + 错误率告警一条 |
| 一周 | 四组指标 + 采样与保留期 + 五条告警各配 Runbook |
| 再往后 | 大盘、GC 指标、按版本拆指标——按需长 |
5.9 练习题
- 假装自己是值班的人:拿一次真实的历史故障,只看日志回答 5.1 的三句话——哪几个客户、哪个页面、几点开始。答不出来,缺的字段就是你要补的。
- 给项目加上 TraceFilter,用 curl -H “X-Trace-Id: abc123” 打一个会报错的接口,确认:日志行里有它、响应头里有它、错误页上能看到它。
- 写一个测试复现上下文丢失:线程池里跑的任务打印 MDC,配 decorator 前后各跑一次,看 traceId 从「全是 null」变成「全程一致」。
- 对你的 MySQL 跑 5.7 的三条 SQL,把当前最贵的 digest 记下来——这就是你系统今天真实的慢查询画像。
- 给自己的告警逐条问一句:它响的时候,值班的人第一步打开什么?答不上来的告警,今天补 Runbook 或者删掉。
5.10 延伸读
- 本章的叙述版:线上出问题,先分清是所有人都慢还是一个人慢
- MDC 租户字段的另一半:多租户系统最容易出事的 8 个位置
- 日志里查状态变更的完整工具链:订单状态机别用 status=1,2,3 糊弄
- 对账不平的分层定位(账在哪一层错的):对账系统最小实现:三边勾稽